02. November 2026 · 8 Min.
AI-Training und robots.txt: das gemeinsame Signal richtig vorbereiten
Google und OpenAI wollen ein gemeinsames robots.txt-Signal für AI-Training unterstützen. Es ist noch kein fertiger Standard und noch nicht überall aktiv — aber jetzt ist der richtige Moment, Inhalte, Ausnahmen und bestehende Bot-Regeln sauber zu ordnen.
Ein Signal für viele Anbieter — aber noch kein Schalter für heute
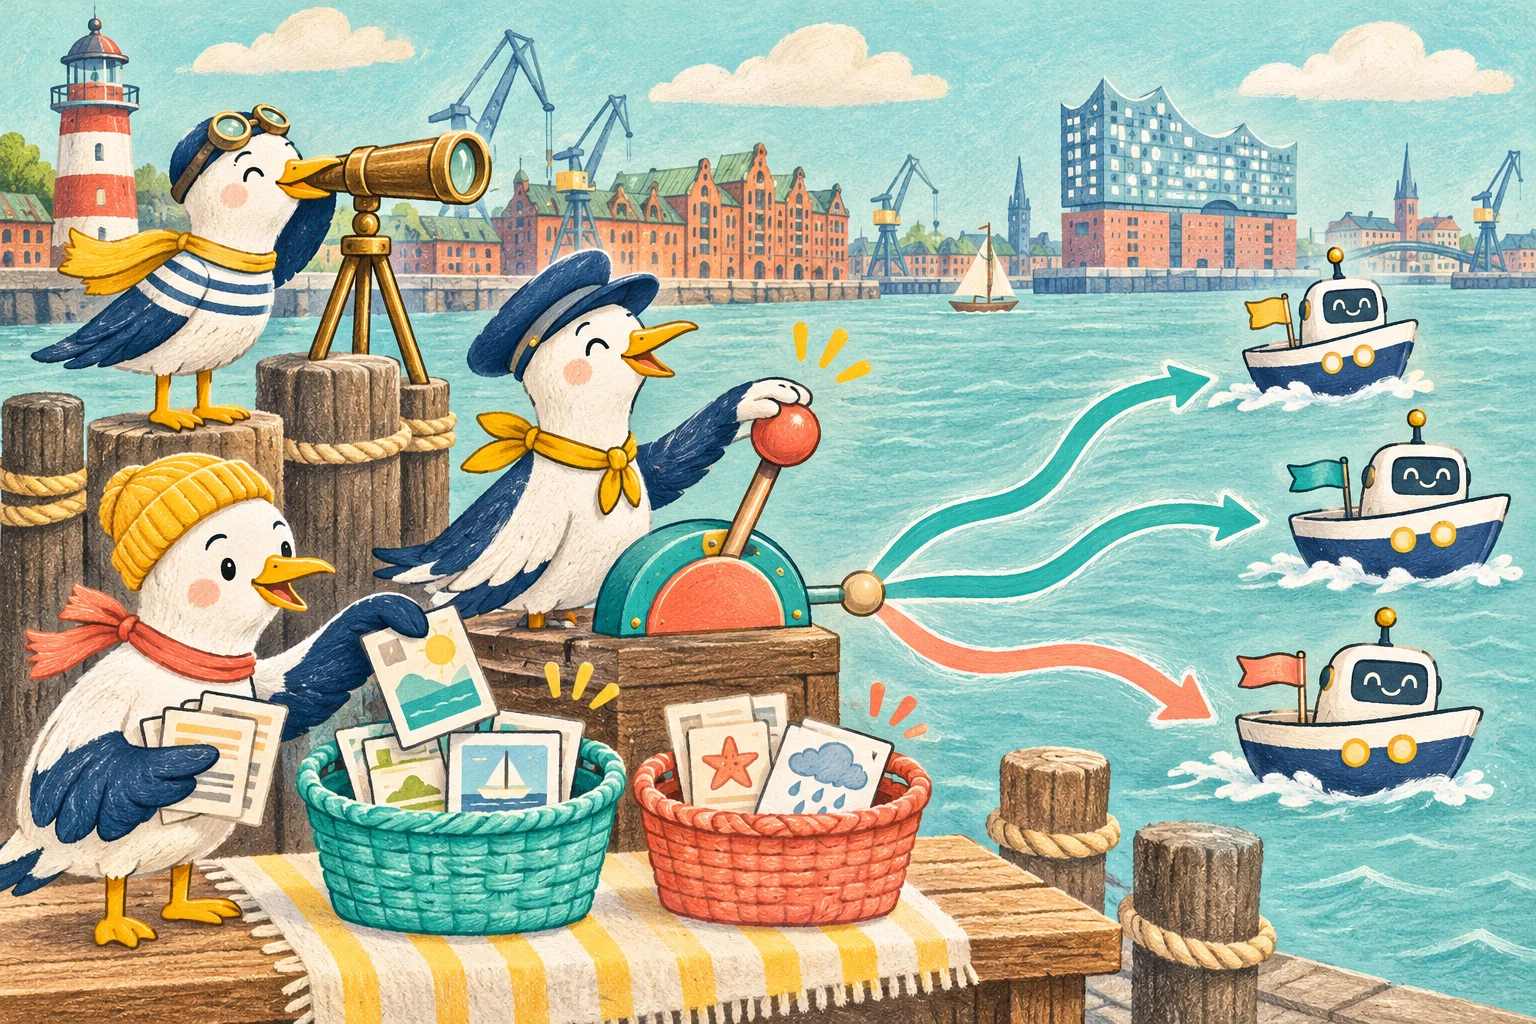
Am 30. Oktober 2026 haben Google und OpenAI angekündigt, ein gemeinsames Signal in robots.txt für die Nutzung von Webinhalten zum Training generativer AI-Modelle zu unterstützen. Die technische Grundlage ist ein neuer Internet-Draft aus der AI Preferences Working Group der IETF.
Die Idee ist nützlich: Statt für jeden Anbieter eine eigene Regel zu pflegen, kann eine Website ihre Präferenz über den gemeinsamen Policy-Token __usage_ai-training ausdrücken. Trotzdem sollte niemand jetzt bestehende Regeln löschen. Der Entwurf ist Work in Progress, Google nennt Anfang 2027 als Ziel und OpenAI spricht von den kommenden Monaten.
Für Website-Teams ist das deshalb kein Copy-and-paste-Ticket, sondern ein guter Anlass, drei Dinge zu klären:
- Welche Inhalte dürfen für generatives AI-Training verwendet werden?
- Welche Inhalte sollen weiterhin in Suche und AI-Grounding auffindbar sein?
- Wer entscheidet, dokumentiert und überprüft diese Regeln?
Was der IETF-Entwurf tatsächlich definiert
Der Draft führt keine neue robots.txt-Grammatik ein. Er verwendet normale User-Agent-Gruppen, Allow- und Disallow-Regeln sowie die bekannte Longest-Match-Logik. Neu ist der zweckgebundene Policy-Token:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Dieses Beispiel drückt eine Präferenz gegen AI-Training für die gesamte Website aus, erlaubt es aber für Inhalte unter /press-kit/. Der Draft definiert AI-Training als Nutzung eines Assets, um die gelernten Parameter eines generativen Modells zu verändern. Reine Klassifikation, Ranking oder Scoring fallen nach dieser Definition nicht automatisch darunter.
Wichtig: Der Entwurf ist ein individueller Internet-Draft. Die IETF weist ausdrücklich darauf hin, dass er noch keine formale Stellung im Standardisierungsprozess besitzt und geändert oder ersetzt werden kann.
Nutzungspräferenz ist nicht Crawl-Steuerung
Der häufigste Denkfehler wird sein: Disallow bedeutet, der Bot darf die URL nicht abrufen. Beim neuen Policy-Token stimmt das nicht automatisch.
Der Draft trennt zwei Ebenen:
- Crawler-Regeln steuern, ob ein bestimmter Crawler Pfade abrufen darf.
- Der Policy-Token beschreibt, ob abgerufene Inhalte für einen bestimmten Zweck verwendet werden sollen.
Wer Crawling technisch begrenzen will, braucht weiterhin Regeln für die tatsächlichen Bot-Tokens. Das gemeinsame Signal ist eine freiwillig interpretierte Nutzungspräferenz. Es ist weder Zugriffsschutz noch DRM und verhindert nicht, dass unbekannte oder nicht kooperierende Crawler Inhalte abrufen.
Sensible Inhalte gehören deshalb hinter Authentifizierung, nicht hinter robots.txt.
Google Search, Google-Extended und das neue Signal auseinanderhalten
Google dokumentiert Google-Extended als separaten Produkt-Token. Er steuert, ob bereits von Google gecrawlte Inhalte für zukünftige Gemini-Modelle sowie für Grounding in Gemini Apps und Vertex AI verwendet werden dürfen. Google-Extended besitzt keinen eigenen HTTP User-Agent; er wirkt als Steuerinformation in robots.txt.
Google sagt ausdrücklich:
- Google-Extended beeinflusst weder die Aufnahme in Google Search noch das Ranking.
- Wenn eine Website künftig das gemeinsame Signal zum Opt-out nutzt und Google-Extended nicht ausdrücklich angibt, will Google dies wie ein Disallow für Google-Extended behandeln.
- Spezifische Google-Extended-Regeln sollen neben dem gemeinsamen Signal weiter funktionieren.
Das bedeutet: Suche, Training und Grounding sind unterschiedliche Produktentscheidungen. Eine einzige Zeile sollte nicht ohne fachliche Prüfung über alle drei Ziele entscheiden.
Bestehende Anbieterregeln vorerst behalten
OpenAI schreibt, dass die neuen Regeln vorhandene Crawler-Kontrollen nicht ersetzen. Google formuliert dasselbe für seine anbieterspezifischen Controls. Bis Implementierungen tatsächlich live und getestet sind, bleiben vorhandene Regeln für GPTBot, Google-Extended, ClaudeBot oder andere Anbieter die belastbare Ebene.
Ein sauberer Übergang sieht so aus:
- Bestehende Gruppen inventarisieren und ihren Zweck dokumentieren.
- Den gemeinsamen Token zusätzlich vorbereiten, nicht als Ersatz einführen.
- Für jeden Anbieter den angekündigten Starttermin und die konkrete Semantik verfolgen.
- Nach dem Rollout mit veröffentlichten Tests oder Anbieter-Dokumentation prüfen.
- Alte Regeln erst entfernen, wenn dieselbe Wirkung nachweislich erreicht wird.
Wer jetzt alle proprietären Gruppen löscht, tauscht Wartungsaufwand gegen eine Kontrolllücke.
Erst eine Content-Policy, dann die robots.txt-Zeilen
Die technische Syntax ist kurz. Die eigentliche Arbeit ist eine Entscheidung über Inhalte. Wir teilen Websites dafür in sinnvolle Klassen:
- Öffentliche Wissensinhalte: Blog, Dokumentation, Hilfeseiten.
- Verkaufsinhalte: Landingpages, Produkttexte, Preis- und Leistungsseiten.
- Markenmaterial: Pressebilder, Logos, freigegebene Beschreibungen.
- Geschützte Arbeit: Kundenprojekte, lizenzierte Medien, bezahlte Inhalte.
- Nutzergenerierte Inhalte: Kommentare, Profile, Community-Beiträge.
Für jede Klasse sollte ein Owner festlegen, ob Training erwünscht, unerwünscht oder noch ungeklärt ist. Dabei gehören Urheberrecht, Kundenverträge, Lizenzen und die eigene Distributionsstrategie an denselben Tisch.
Eine pauschale Entscheidung ist bequem. Eine dokumentierte Entscheidung pro Inhaltsklasse ist meist besser.
Pfadausnahmen bewusst einsetzen
Der Policy-Token unterstützt Pfade. Damit kann eine Marke beispielsweise Training für redaktionelle Artikel ablehnen, aber ein freigegebenes Press Kit erlauben. Umgekehrt kann ein Open-Source-Projekt Dokumentation erlauben und einen Bereich mit Drittanbieter-Material ausschließen.
Pfadregeln werden jedoch schnell fragil, wenn URL-Strukturen nicht den inhaltlichen Besitz spiegeln. Vor dem Einsatz prüfen wir deshalb:
- Sind Inhalte klar nach Zweck und Rechten getrennt?
- Können CMS-Redakteure Inhalte versehentlich in den falschen Pfad verschieben?
- Gibt es Sprach- oder Länderpfade mit abweichenden Lizenzen?
- Entstehen Kopien über Parameter, Print-Views oder alte URLs?
- Wird robots.txt bei jedem Deployment unverändert ausgeliefert?
Eine Präferenz ist nur so zuverlässig wie die URL-Architektur dahinter.
Wildcard ist keine Abkürzung
Der IETF-Draft sagt ausdrücklich, dass **User-Agent: *** nicht als Match für den Policy-Token interpretiert werden darf. Wer nur eine allgemeine Disallow-Regel besitzt, hat damit noch keine AI-Training-Präferenz im Sinne des Entwurfs ausgedrückt.
Der gemeinsame Token braucht eine eigene, explizite Gruppe. Das schützt auch davor, versehentlich Search-Crawler zu blockieren, wenn eigentlich nur eine Nutzungspräferenz gemeint war.
Ebenso wichtig ist die Präzedenz: Spezifische anbieterspezifische Policy-Tokens können allgemeine Regeln übersteuern, wenn der jeweilige Anbieter dies dokumentiert. Diese Reihenfolge gehört in die technische Dokumentation und in Tests.
robots.txt wie Konfiguration behandeln
Viele Websites erzeugen robots.txt als beiläufige Textdatei. Mit mehr Produkt- und Nutzungsregeln wird sie zu veröffentlichter Policy-Konfiguration. Das verlangt dieselbe Sorgfalt wie Redirects oder Security Header:
- Datei im Repository versionieren;
- Änderungen per Review freigeben;
- Syntax und erwartete Gruppen in CI testen;
- Produktion nach dem Deployment abrufen;
- Änderungen mit Datum, Owner und Entscheidungsgrund dokumentieren;
- Monitoring auf unerwartete Überschreibungen durch CMS, CDN oder Hosting einrichten.
Bei mehreren Domains braucht jede Origin ihre eigene Prüfung. Ein korrektes robots.txt auf www.example.com sagt nichts über docs.example.com oder einen Asset-Host aus.
Was Teams jetzt konkret tun sollten
Der sinnvolle November-Plan ist klein und reversibel:
- Aktuelle robots.txt-Dateien aller relevanten Hosts sichern.
- Bestehende Search-, Training- und Grounding-Regeln getrennt beschriften.
- Inhaltsklassen und Rechteinhaber in einem kurzen Policy-Dokument festhalten.
- Eine gewünschte Konfiguration mit __usage_ai-training in Staging vorbereiten.
- Den gemeinsamen Token noch nicht als Ersatz für funktionierende Anbieterregeln behandeln.
- Für Anfang 2027 einen Review-Termin und Anbieter-Checks einplanen.
So ist das Team bereit, ohne eine unfertige Spezifikation vorschnell zur Produktionswahrheit zu erklären.
Unser Fazit
Ein gemeinsames AI-Training-Signal kann Website-Betreibern viel doppelte Pflege ersparen. Sein größter Wert liegt aber nicht in einer kürzeren robots.txt-Datei. Es zwingt Teams, Training, Crawling, Search-Sichtbarkeit und Grounding als getrennte Entscheidungen zu behandeln.
Wer heute Inhalte und Verantwortlichkeiten ordnet, kann den neuen Token später kontrolliert aktivieren. Wer nur eine Zeile kopiert, hat zwar eine Präferenz veröffentlicht — aber noch keine belastbare Content-Policy.
Primärquellen