29. September 2026 · 10 Min.
Self-hosted Runner: Eine Pipeline, eine frische Maschine
Seit dem 25. September blockiert GitHub veraltete self-hosted Runner konsequenter. Der bessere Fix ist größer als ein Update: CI-Maschinen kurzlebig, isoliert und reproduzierbar bauen.
Wenn die Pipeline plötzlich nur noch wartet
Seit dem 25. September 2026 setzt GitHub die Mindestversionen für self-hosted Actions Runner vollständig durch. Ein zu alter Runner kann sich nicht mehr neu registrieren oder bekommt keine Jobs mehr. Jede neue Runner-Version — Major, Minor oder Patch — startet dabei ein 30-Tage-Fenster. Bei einem kritischen Sicherheitsupdate kann GitHub die Job-Zuteilung früher stoppen.
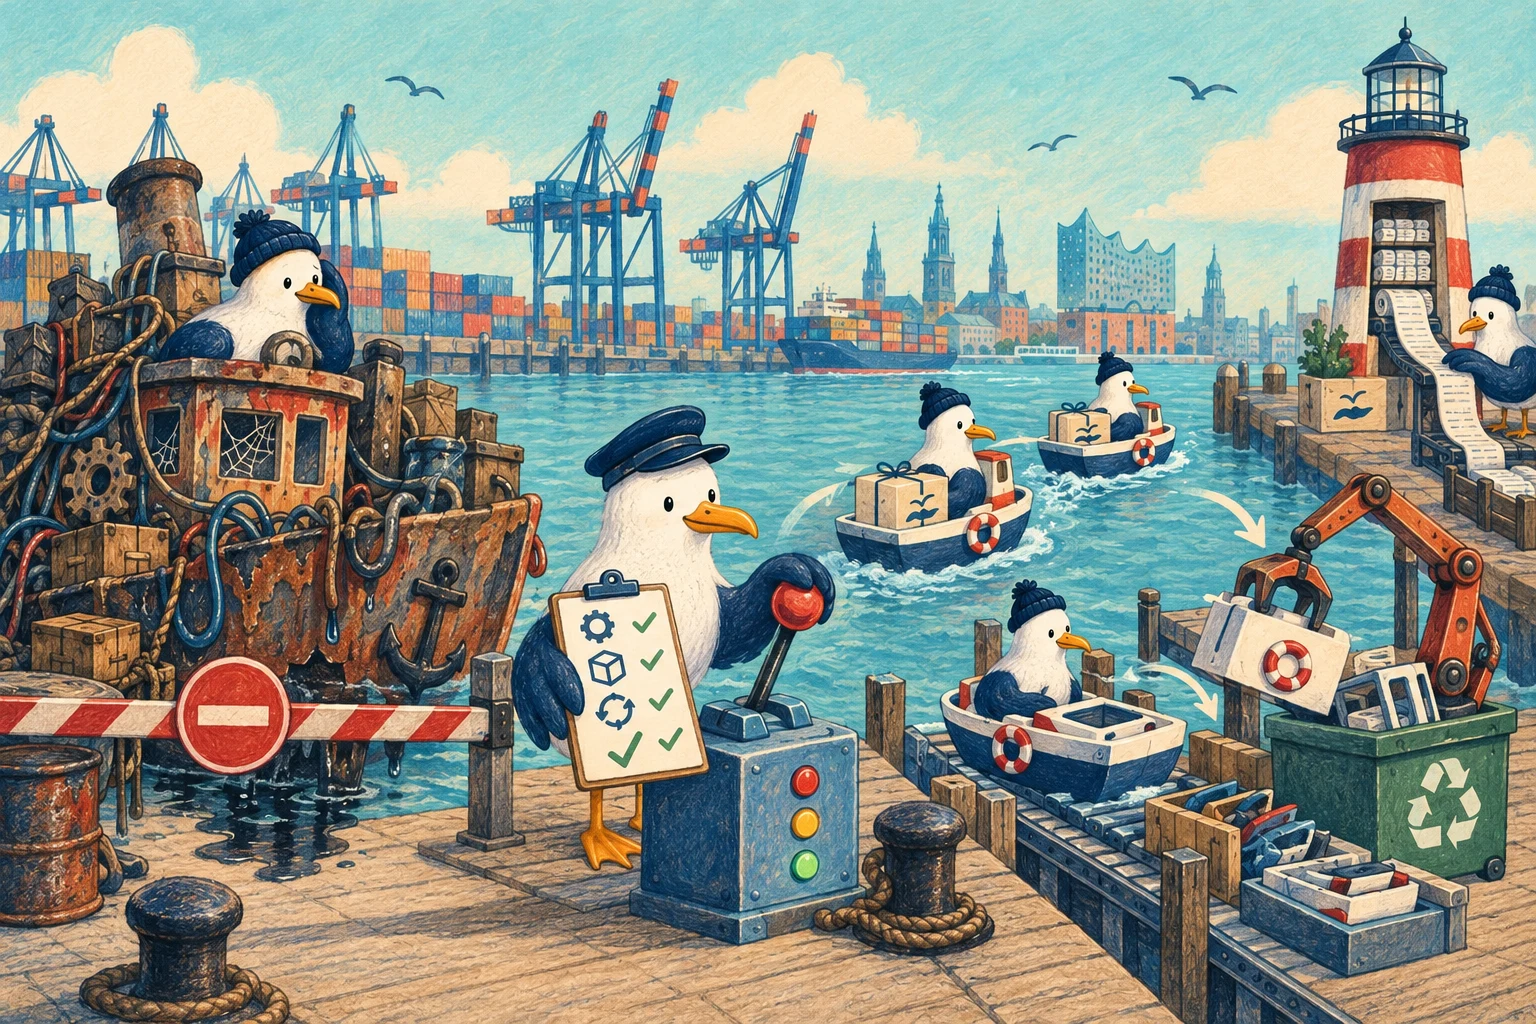
Das akute Symptom ist harmlos aussehend: Deployments stehen auf „queued“, obwohl die Maschine erreichbar ist. Das eigentliche Signal ist größer. Ein self-hosted Runner ist kein Server, den man einmal aufsetzt und dann jahrelang pflegt. Er führt fremdbestimmten Code mit Zugang zu Quellcode, Artefakten, Netzwerken und oft Secrets aus. Er gehört deshalb wie ein Wegwerf-Werkzeug behandelt: frisch für einen Job, danach weg.
Diese Lektion gilt nicht nur für GitHub Actions. GitLab warnt ebenfalls davor, nicht-flüchtige Runner projektübergreifend zu verwenden. Wer seine eigene CI-Rechenleistung betreibt, übernimmt Isolation, Updates, Logs und Schadensbegrenzung selbst.
Was ein Runner tatsächlich ausführt
Eine Pipeline ist Remote Code Execution mit freundlichem YAML. Ein Job darf Shell-Befehle starten, Pakete installieren, Container bauen und Dateien aus dem Repository interpretieren. Schon ein scheinbar normaler Schritt wie npm install kann Skripte ausführen. Ein Test kann auf Netzwerkziele zugreifen. Ein Build-Plugin kann Umgebungsvariablen lesen.
Auf einem dauerhaften Runner bleiben mehr Dinge zurück, als Teams erwarten:
- Arbeitsverzeichnisse und temporäre Dateien;
- Docker-Layer, Images und Volumes;
- Package-Manager-Caches;
- SSH-Konfiguration, Cloud-CLI-Sitzungen oder Credentials Helper;
- Prozesse, die einen Job überleben;
- Netzwerkzugang zu internen Diensten;
- Artefakte eines anderen Projekts.
Ein nachfolgender Job trifft damit nicht auf eine definierte Umgebung, sondern auf Geschichte. Das erzeugt zwei Probleme zugleich: Builds werden schwer reproduzierbar und ein kompromittierter Job kann den nächsten beeinflussen.
Ephemeral heißt: genau ein Auftrag
GitHub empfiehlt für Autoscaling ausdrücklich ephemere Runner und rät von persistenten Autoscaling-Runnern ab. Ein ephemerer Runner erhält genau einen Job und wird danach deregistriert. Die Infrastruktur muss die Maschine oder den Container anschließend wirklich entfernen und nicht bloß den Arbeitsordner leeren.
GitLab beschreibt dasselbe Ziel für den Instance Executor: Mit Kapazität 1 und Use Count 1 erhält jeder Job eine eigene Instanz, die nach Abschluss gelöscht wird. Bei älteren Docker-Machine-Setups erfüllt MaxBuilds = 1 denselben Grundgedanken.
Die Plattformbegriffe unterscheiden sich, das Architekturprinzip bleibt:
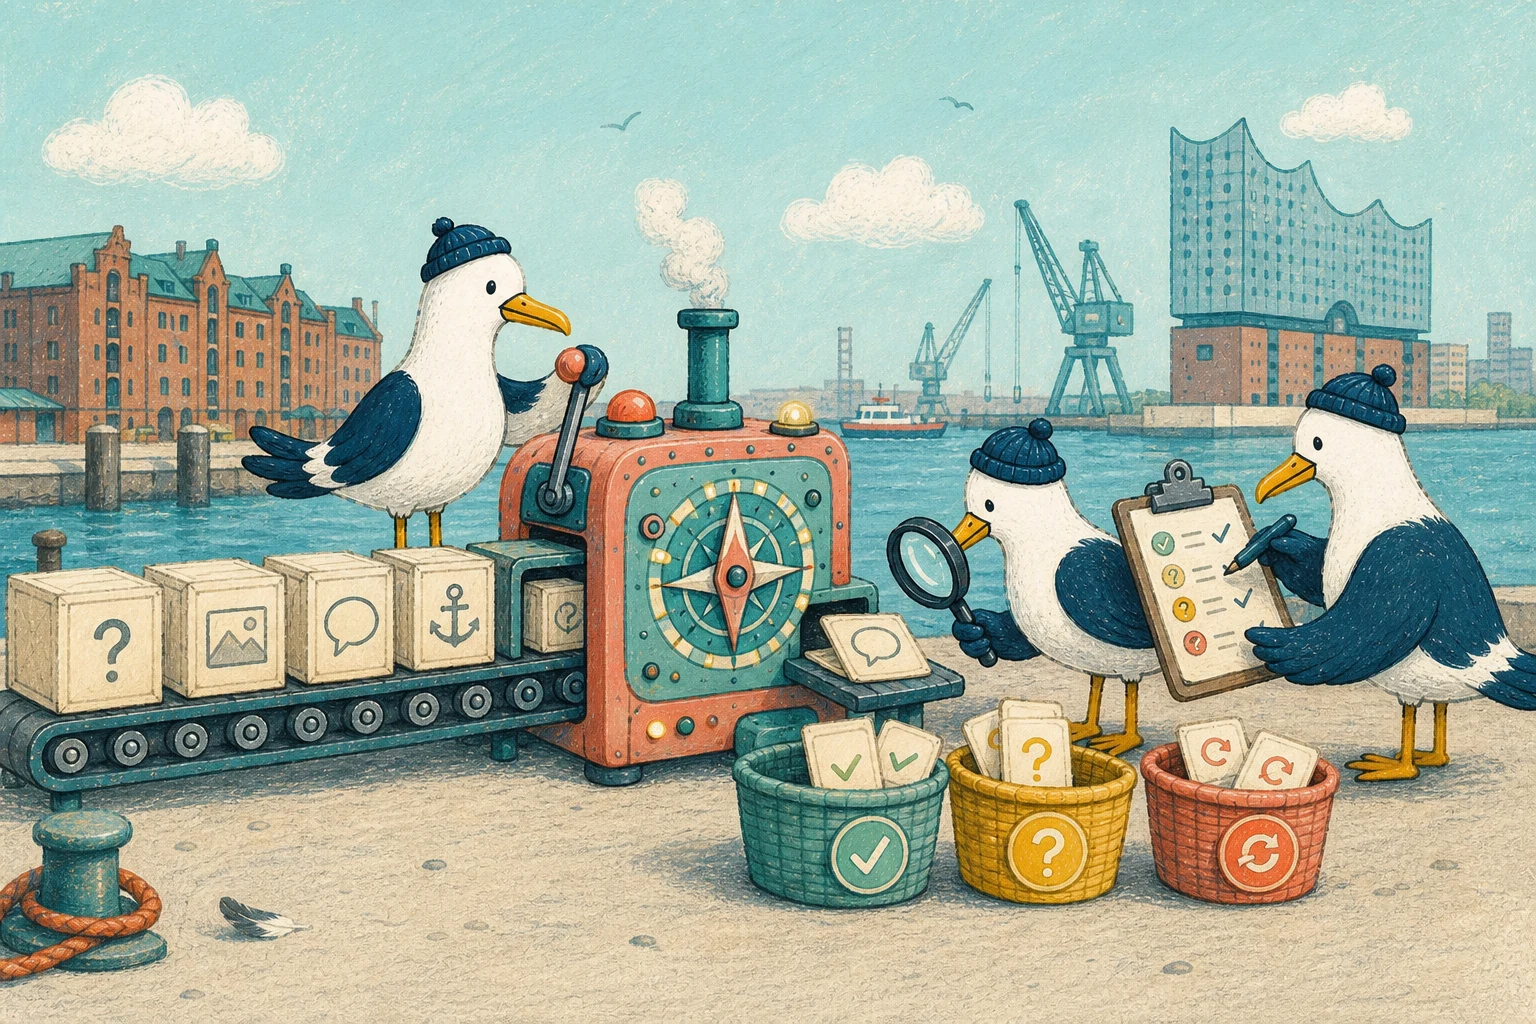
- Ein Job wird in die Queue gestellt.
- Automatisierung erzeugt eine Instanz aus einem bekannten Image.
- Der Runner registriert sich mit kurzlebigen Zugangsdaten.
- Genau ein Job läuft.
- Logs und benötigte Artefakte verlassen die Instanz.
- Die Instanz wird vollständig zerstört.
„Ephemeral“ ist also kein Label im CI-Dashboard. Es ist eine überprüfbare Lebenszyklus-Garantie.
Das Image ist das Produkt
Wenn Maschinen kurz leben, wandert die Konfiguration in ein versioniertes Image. Darin liegen Betriebssystem, Runner, Build-Werkzeuge, Zertifikate und die wirklich benötigten Hilfsprogramme. Änderungen laufen durch denselben Review-Prozess wie Anwendungscode.
Ein gutes Runner-Image beantwortet vier Fragen:
- Aus welcher unveränderlichen Basis wurde es gebaut?
- Welche Versionen von Runner und Toolchain enthält es?
- Wann wurde es zuletzt neu gebaut und geprüft?
- Welche Pipelines dürfen es verwenden?
GitHub aktualisiert die Runner-Anwendung standardmäßig selbst. In Container-Images kann das bei jedem Start unnötige Downloads verursachen. Wer automatische Runner-Updates mit --disableupdate abschaltet, übernimmt jedoch verbindlich die Aktualisierung des Images und muss innerhalb des unterstützten Fensters neu bauen. Wichtig: Das Runner-Update pflegt nicht automatisch Betriebssystem, Docker, Browser, SDKs oder andere Tools. Dafür braucht es einen eigenen Patch-Zyklus.
Praktisch bauen wir Images regelmäßig, nicht erst bei einer Warnung. Ein nächtlicher Build kann neue Patches aufnehmen; ein kleiner Smoke-Test prüft Registrierung, Checkout, Cache, Artefakt-Upload und Netzwerkzugriff. Erst danach wird der neue Image-Digest freigegeben.
Vertrauenszonen statt eines großen Runner-Pools
Ein Runner, der Pull Requests ausführt, hat ein anderes Risiko als ein Runner, der Produktion ausliefert. Beide in denselben Pool zu legen, verbindet untrusted Code mit wertvollen Berechtigungen.
Wir trennen mindestens drei Zonen:
Untrusted Check: Tests für externe oder nicht freigegebene Änderungen. Keine Production-Secrets, kein Zugriff auf interne Netze, read-only Token, ephemere Instanz.
Trusted Build: Läuft erst nach Review oder auf geschützten Branches. Darf Artefakte signieren oder in eine Registry schreiben, bekommt aber noch keinen direkten Produktionszugang.
Deploy: Verwendet ein bereits gebautes, eindeutig identifiziertes Artefakt. Die Freigabe ist separat, Secrets sind auf diesen Job begrenzt und die Umgebung akzeptiert nur die notwendigen Ziele.
So wird eine Pipeline nicht durch einen einzelnen „if branch equals main“-Satz sicher. Die Grenzen existieren in Runner-Gruppen, Netzwerkregeln, Identitäten und Secret Policies.
Pull Requests sind Code von außen
GitHub führt ab November 2026 für betroffene öffentliche Repositories eine strengere Standardregel für pull_request_target durch. Der Trigger läuft im Kontext des Basis-Repositorys und kann privilegierte Tokens oder Secrets sehen. Wenn der Workflow dann den Code eines Forks auscheckt und ausführt, entsteht eine klassische Pwn-Request-Lücke.
Die sichere Standardentscheidung lautet: Für normale Tests pull_request verwenden. Wenn ein privilegierter Folgeprozess nötig ist, Eingaben als Daten behandeln, Berechtigungen minimieren und den vertrauenswürdigen Teil klar abtrennen. Ein self-hosted Runner für untrusted Pull Requests darf weder interne Dienste erreichen noch nach dem Job wiederverwendet werden.
Dabei zählt mehr als der offensichtliche Build-Befehl. Abhängigkeiten, Build-Konfiguration, Test-Fixtures und heruntergeladene Artefakte können ebenfalls Code ausführen. „Wir starten nur Tests“ ist keine Sicherheitsgrenze.
Secrets möglichst spät und kurz vergeben
Ein langlebiges Cloud-Passwort auf der Runner-Festplatte widerspricht dem ephemeren Modell. Besser sind kurzlebige, jobgebundene Identitäten: Der Job weist gegenüber dem Cloud-Anbieter nach, welcher Workflow und welches Repository ihn gestartet haben, und erhält nur für diesen Lauf ein begrenztes Token.
Wo das nicht möglich ist:
- Secrets nur an vertrauenswürdige Jobs geben;
- Werte auf Umgebung und Zweck begrenzen;
- Maskierung nicht mit Schutz verwechseln;
- Rotation automatisieren;
- Schreibrechte und Netzwerkziele minimieren;
- niemals Secrets in Images, Caches oder Artefakte einbacken.
Ein ephemerer Runner reduziert die Zeit, in der gestohlene Daten auf der Maschine liegen. Er ersetzt aber keine saubere Berechtigungspolitik.
Cache und Artefakte sind zwei verschiedene Dinge
Ein Cache beschleunigt den nächsten Build. Ein Artefakt ist ein Ergebnis, das nachvollziehbar weitergegeben wird. Wer beides vermischt, macht alte, veränderbare Daten zur Grundlage eines Releases.
Caches sollten untrusted Jobs nicht überschreiben können, wenn trusted Jobs sie später verwenden. Cache-Keys brauchen Abhängigkeiten, Plattform und relevante Lockfile-Hashes. Für Releases verwenden wir unveränderliche Artefakte mit Digest, Herkunft und klarer Aufbewahrung — nicht irgendeinen Ordner aus dem letzten Runner.
Auch ein sauberer Runner darf schlechte Eingaben laden. Isolation schützt die Maschine, Provenance schützt den Weg des Ergebnisses.
Logs müssen den Runner überleben
Ein weggeworfener Runner nimmt seine lokale Diagnose mit. GitHub empfiehlt deshalb ausdrücklich, Logs ephemerer Runner an einen externen Speicher weiterzuleiten. Dazu gehören nicht nur die sichtbaren Job-Logs, sondern auch Start, Registrierung, Image-Version, Instanz-ID, Löschung und Infrastrukturfehler.
Wir wollen nach einem Fehlschlag beantworten können:
- Welcher Image-Digest lief?
- Wann wurde die Instanz erzeugt und gelöscht?
- Welcher Job und welches Repository waren zugeordnet?
- Erreichte der Runner die benötigten Dienste?
- Wurde das Log vollständig übertragen?
Die Daten brauchen eine begrenzte Aufbewahrung und dürfen keine Secrets enthalten. Ohne externe Logs wird Ephemeral Computing bei der ersten Störung schnell zu Blindflug.
Ein realistischer Umbau ohne Big Bang
Der Wechsel muss nicht mit einem Kubernetes-Cluster beginnen. Für wenige Jobs kann ein gehosteter Runner günstiger und sicherer sein als eine eigene Flotte. Wenn spezielle Hardware, private Netze oder lizenzierte Tools self-hosted nötig machen, gehen wir schrittweise vor:
- Runner-Inventar mit Version, Owner, Projekten und Netzwerkzugriff erstellen.
- Veraltete Runner sofort aktualisieren und Queue-Warnungen beobachten.
- Untrusted und privileged Jobs in getrennte Gruppen verschieben.
- Ein reproduzierbares Image für den häufigsten Job bauen.
- Erst einen Pipeline-Typ auf Ein-Job-Instanzen migrieren.
- Logs und Löschvorgänge außerhalb der Instanz nachweisen.
- Caches, Kosten und Startzeiten messen und dann skalieren.
Der Erfolg ist nicht „der Job läuft wieder“. Erfolgreich ist der Umbau, wenn eine Instanz nach dem Job nichts mehr besitzt, was den nächsten Job beeinflussen kann.
CI ist Produktionsinfrastruktur
Die neue Versionsdurchsetzung macht sichtbar, was ohnehin galt: Ein self-hosted Runner ist Teil der Software-Lieferkette. Er braucht Patch-Fenster, Verantwortliche, minimale Rechte, externe Beobachtbarkeit und einen getesteten Ersatzweg.
Die stärkste Vereinfachung ist dabei radikal klein: eine Pipeline, eine frische Maschine, ein klarer Output — danach wird aufgeräumt, indem die Maschine verschwindet.
Quellen